科研产物的 RSI:让每一次改进接受检验
一个算法已经能跑,是否还能更快、更准确,或用更少的空间?一份方案已有雏形,能否在明确标准下继续改进?科研产物的 RSI 将“修改—评价—再修改”变成有记录的搜索过程。
在 ScienceDiscovery 中,这项能力通过 /evolve-design 发起。这里改进的是程序或其他可评价的文本产物,模型权重并不会因此被训练或更新。你定义什么叫“更好”,系统生成变体、逐个评分、保留有效方案,最后再检查它们在留出数据上的表现。
先找到一把有用的尺子
搜索可以不断产生新代码,但只有评价标准能够告诉它哪些修改值得保留。例如,文本压缩任务首先要求解压后完全还原原文,在此前提下再比较压缩后的字节数。若只奖励文件小,丢弃输入反而可能得到高分。
系统支持用数据指标、测试套件、自定义脚本或模型评审来评价候选。适合哪一种,取决于你的目标能否直接测量。代码可以运行测试;文本方案可能需要清楚的评分细则。模型评审带有波动,不能当成精确测量。
启动前的探针会检查评分方案能否区分正常与被破坏的候选、是否存在改进空间等问题。这能帮助发现明显失效的评价设计,但不能保证指标已经完整代表科研目标。
在改进与探索之间分配机会
PUCT 将候选组织成树,在继续打磨有希望的分支和探索其他方向之间分配尝试。OpenEvolve 使用种群与归档保留不同类型的候选,适合希望同时探索多种路线的任务。两者共用评分与交付流程。
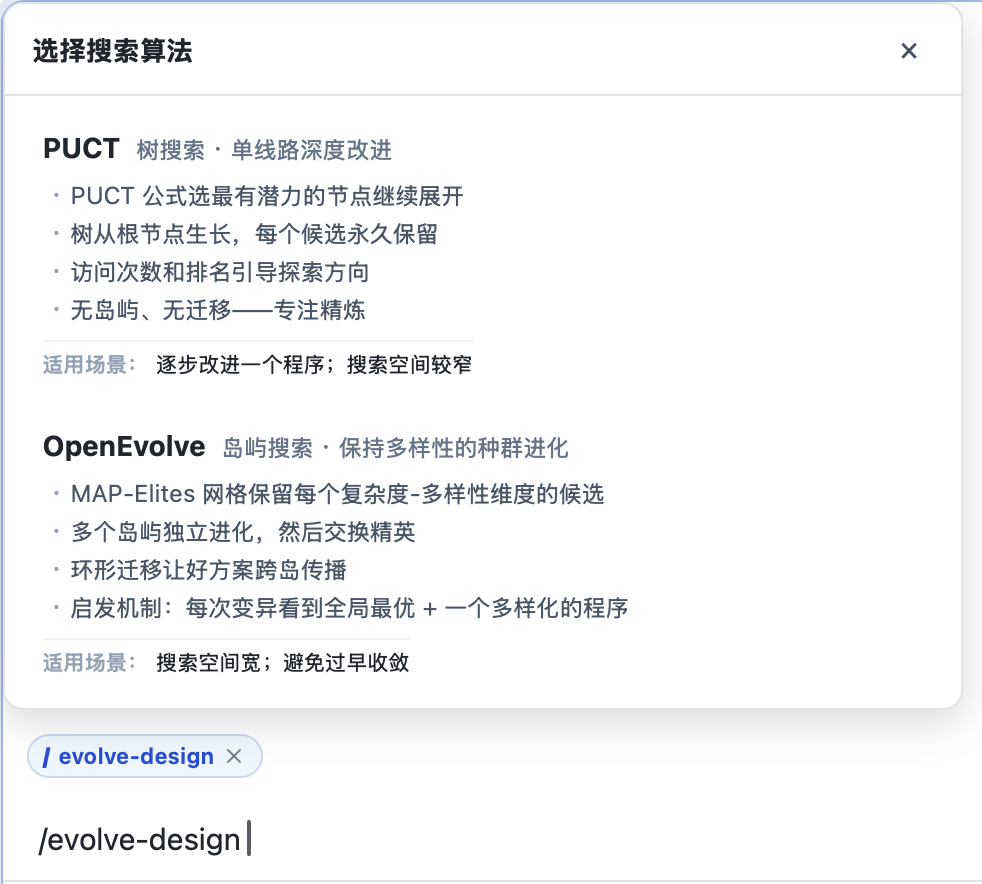
运行面板展示候选、分数和演进关系。一次失败的候选也有价值:它告诉你某条修改路线没有通过检验。搜索不保证每次都超越起点;保留原方案可以是合理结果。
用留出集检查改进能否延续
搜索过程中用于比较候选的数据,与最终的留出测试数据分开使用,评分器在同一次搜索中保持冻结。这样的安排减少了反复挑选候选对最终评价的直接影响。
留出分仍然只描述所选测试数据上的表现。数据过窄、评分上限过早饱和,或指标偏离真实需求,都会限制分数的意义。解释结果时,应同时查看起点、搜索评分和留出评分,而不是只报一个最高值。
交付的是可以继续研究的版本
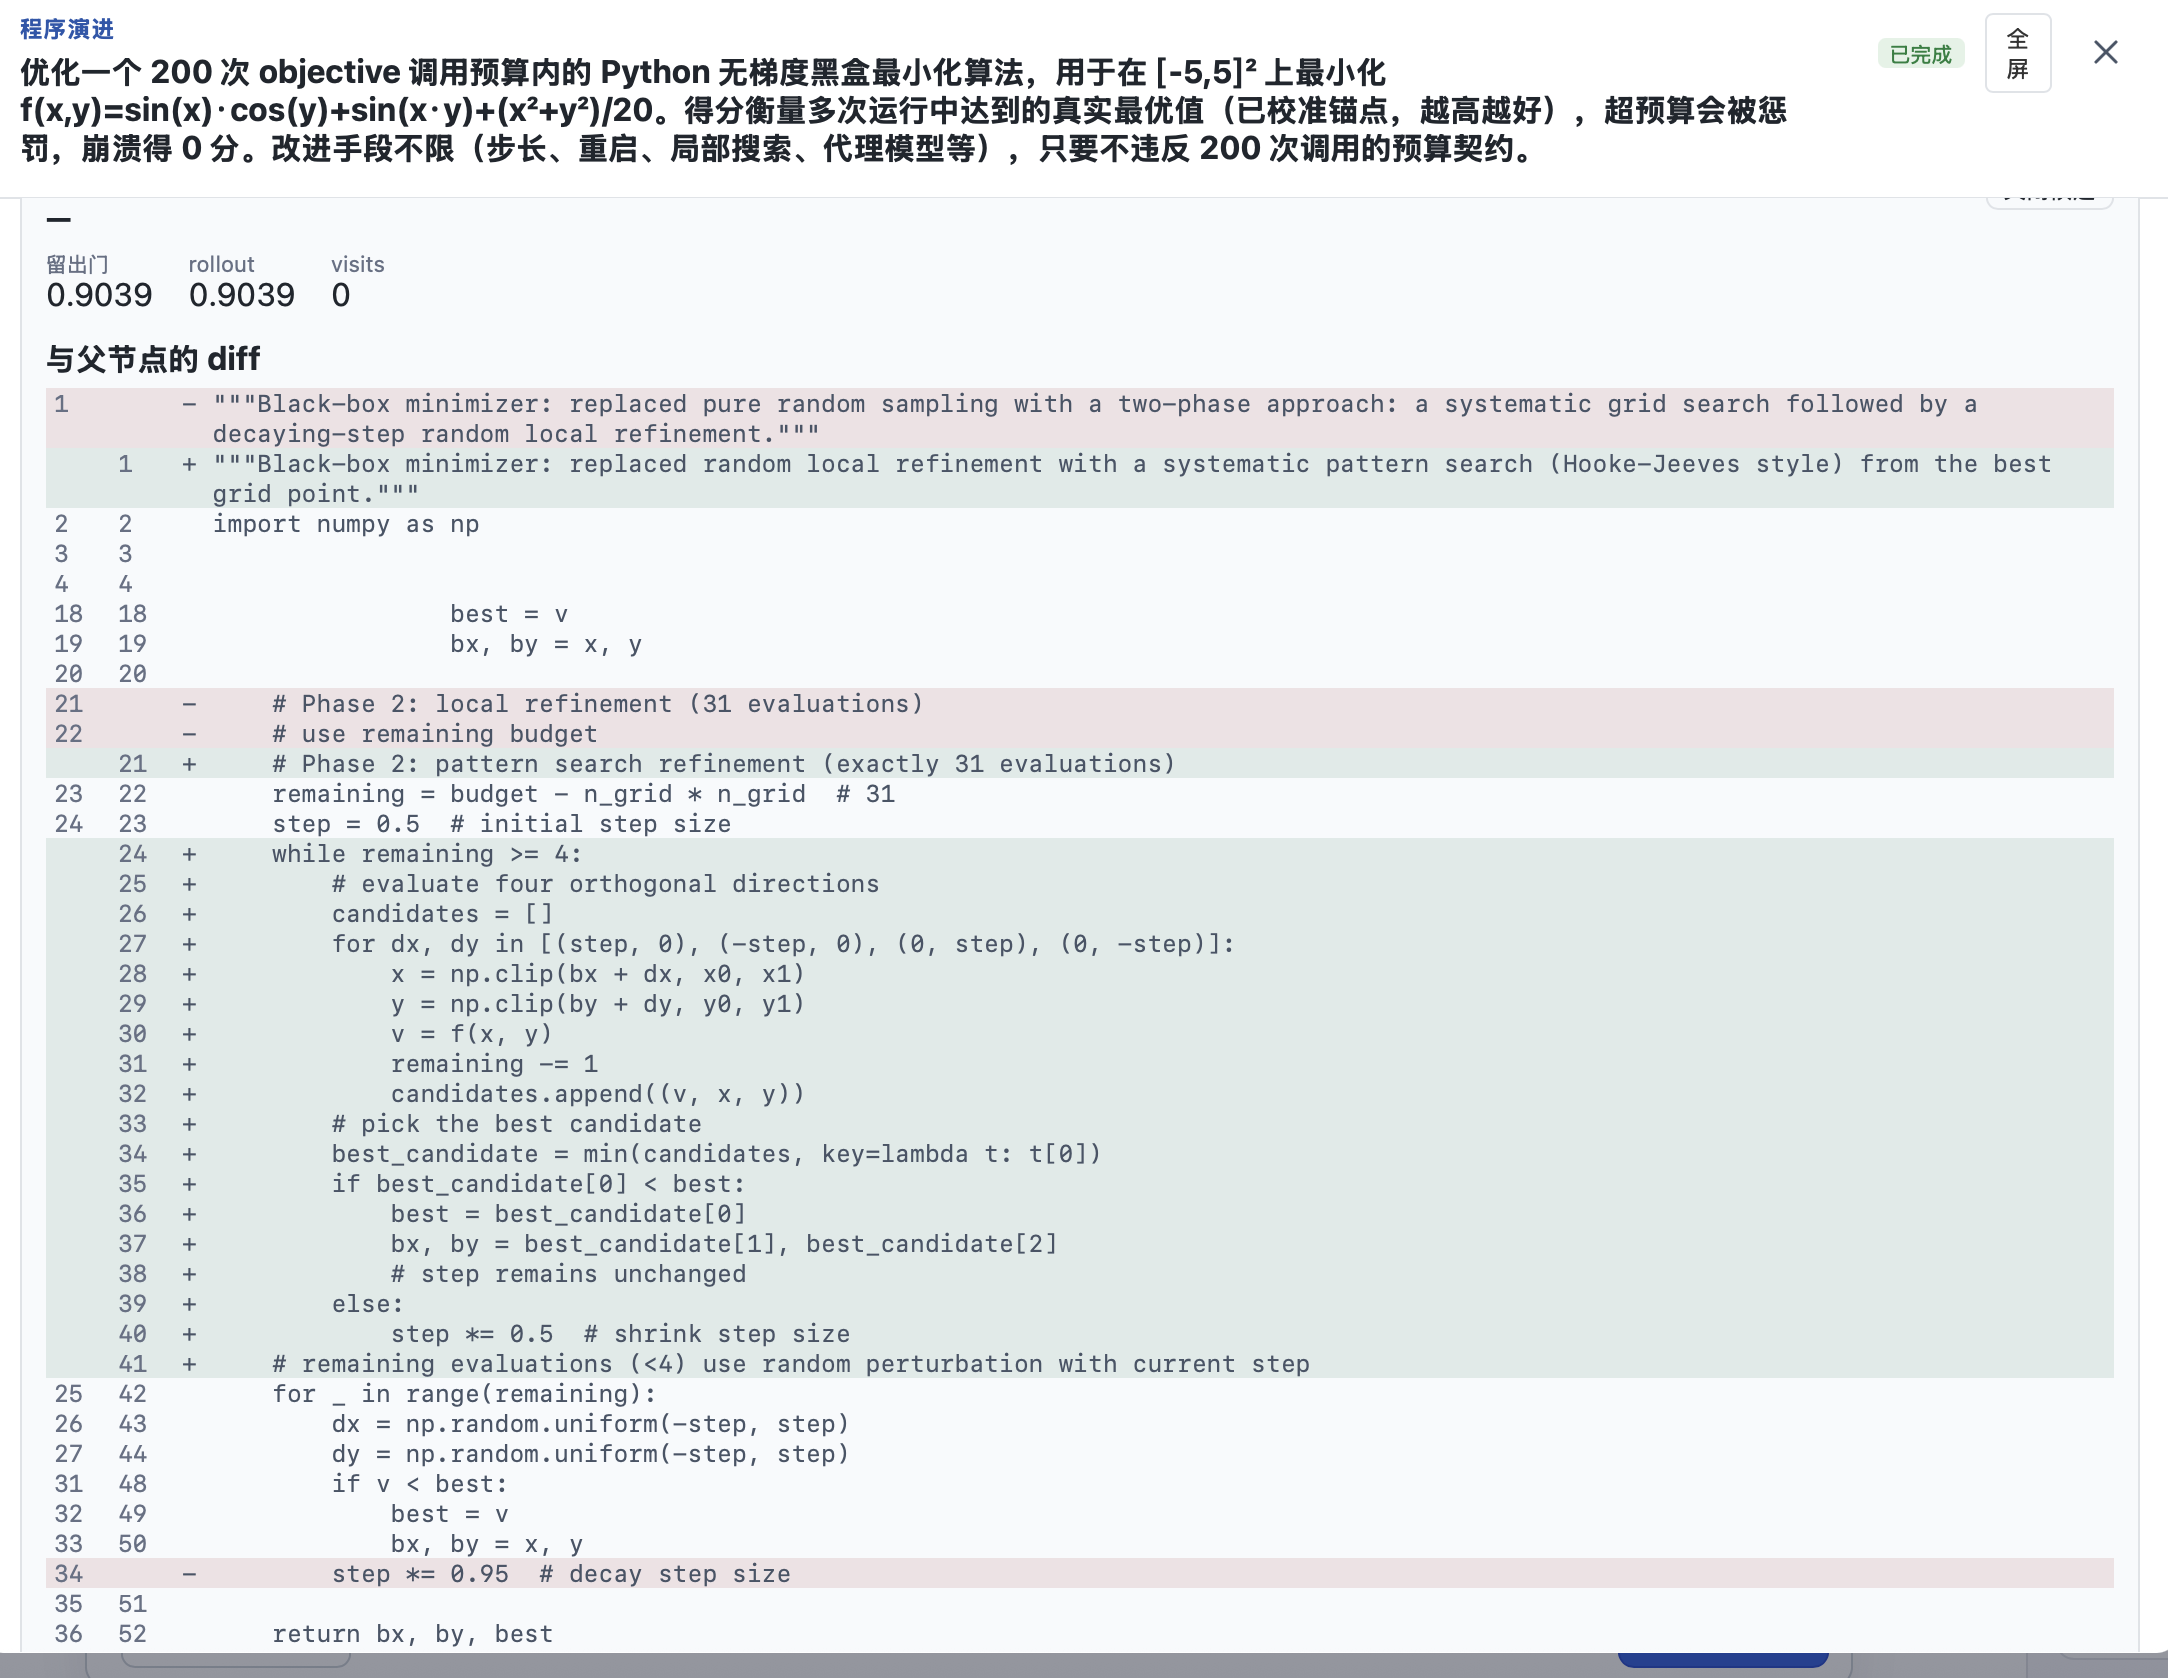
找到改进后,产物版本和代码差异帮助你回答“究竟改了什么”。你可以下载结果、复核评测,或以已有版本为起点继续探索。这种小步迭代尤其适合已经有可运行起点、又能明确评价改进的任务。
Idea Tree 侧重比较研究方向与方案;RSI 侧重围绕一个可评价产物反复优化。二者可以用于不同研究阶段,但不会自动串成一条完整实验流程。
- PUCT 文本压缩教程:完成一次真实的程序优化。
- 演进引擎与部署:评分方式、引擎与执行设计。
- Idea Tree:探索还未确定的研究方向。