使用PUCT优化一个文本压缩算法
问题背景
假设你需要保存大量文本,希望文件更小,同时能够完整还原原文。你已经有一个能运行的压缩算法,但不知道怎样继续改进它。
本教程用这个问题演示程序演进:先让 Agent 写出一个简单、可用的压缩器和评测脚本,再由 PUCT 搜索不断修改代码、运行评测、保留更好的候选。PUCT 会在不同修改方向之间分配尝试机会,既继续改进已有的好方案,也探索其他方向。
任务有两个函数:compress(text) -> bytes 和 decompress(bytes) -> str。解压后的文本必须与原文完全相同;代码只能使用 Python 标准库,不能使用 zlib、lzma、bz2。优化目标是在满足这些要求的前提下,让压缩后的字节数更少。
完成教程后,你会得到起点代码、评测脚本、搜索结果,以及未参与搜索的留出测试分数。
准备工作
先完成快速开始,启动服务并配置一个可用的任务模型。模型用于设计方案和生成候选代码,运行会产生模型调用费用。
在系统配置中确认 Python 科学计算环境已就绪,并且沙箱执行可用。不要使用 --skip-sandbox-check 绕过沙箱检查:演进搜索需要在沙箱中运行候选程序。科学记忆是可选功能,本教程不要求开启。
这次任务不需要上传数据。Agent 会编写评测脚本,生成用于测试的文本。建议预留十几分钟;实际耗时取决于模型、搜索规模和候选代码的执行速度。
任务开始
新建 Project 和 Session,在对话框中输入:
/evolve-design 写一对处理文本的 compress/decompress:compress(text) -> bytes、
decompress(bytes) -> str。往返必须完全无损。只用标准库 —— 不许用 zlib、lzma、bz2。
分数是压缩后小了多少。
输入 /evolve-design 后会出现算法选择器,选择 PUCT,然后发送任务。
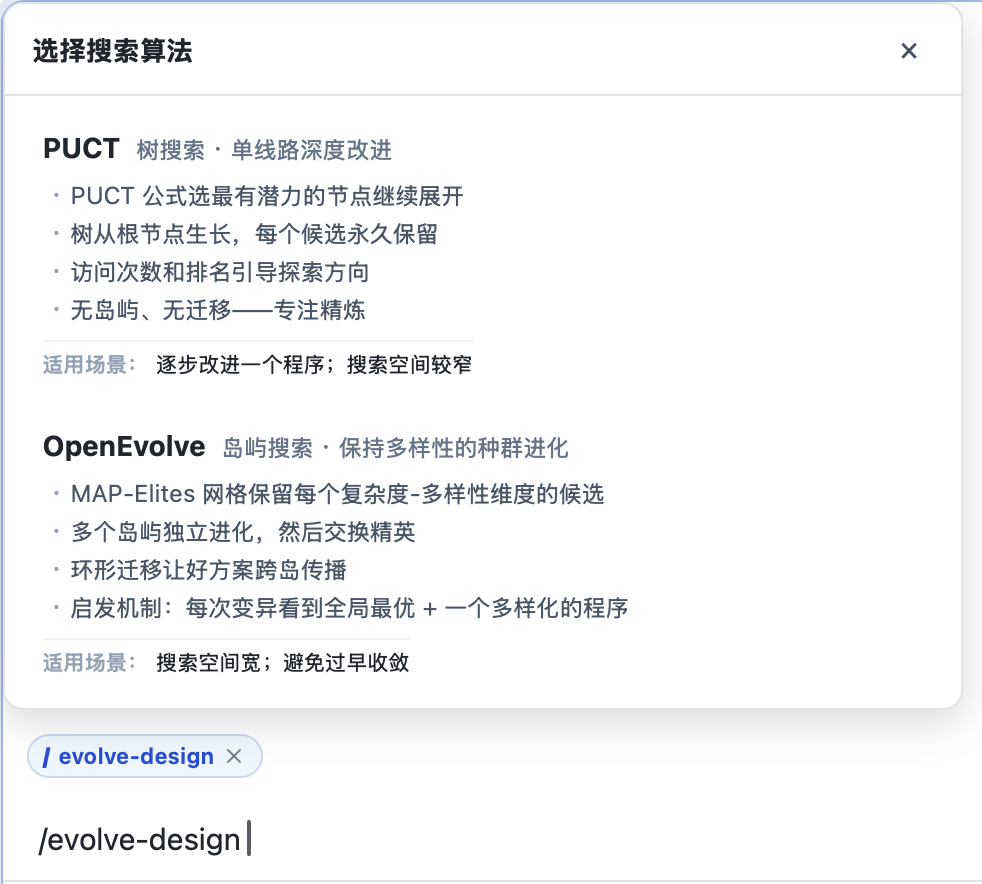
你也可以在命令中明确指定算法:/evolve-design --algorithm puct …。
选择器还提供基于种群搜索的 OpenEvolve。本教程全程使用 PUCT;两种引擎的区别见程序演进。
确定要求
Agent 会加载演进设计技能,并准备起点程序、评测方式和搜索规模。阅读它给出的方案时,重点确认以下内容:
| 要确认的内容 | 本教程中的要求 |
|---|---|
| 输入与输出 | 接收文本,输出压缩字节;解压后得到原文 |
| 正确性 | 每条测试文本都做压缩、解压和逐字比较;失败不能获得有效的压缩收益 |
| 实现限制 | 只用标准库;评测器应检查禁止使用的压缩库,不能只在提示词中声明 |
| 优化目标 | 根据压缩前后的字节数计算分数,并说明分数的范围、归一化方式和上限 |
| 起点 | 一个已经能压缩和还原文本的简单算法,例如 Huffman 编码;不应只是原样返回输入 |
| 数据 | 使用多种文本,避免只在一种重复字符串上表现很好 |
接着确认评测数据如何划分。你会看到三个名称:
- gate:用来比较候选、决定搜索方向的评分集。
- rollout:供搜索内部使用的另一组数据。
- test:留到最后才使用,不参与候选选择,最终结果优先看它。
第一次可以采用 gate 12、rollout 6、test 6,16 次扩展、4 个 worker。这里一个分片代表一组测试文本;一次扩展是生成并评测一个候选,worker 表示搜索并行度。这是一套参考规模,不要求每次生成完全一样的方案。
技能设计了需求、评测、规模和启动结果四个检查点。Agent 停下来询问时,你可以确认或提出修改;想使用它给出的合理默认值,可以回复:
你决定,按文档推荐规模直接跑;使用 PUCT,完成余下检查点并启动搜索。模型也可能一次给出完整方案并直接启动。本次实测就出现了这种行为,因此不要依赖它一定逐项停顿。如果你希望亲自确认,请在最初的任务中明确要求“启动搜索前先等我确认”。
启动前,服务会用正常起点和被破坏的程序等进行判别力探针,检查评测器能否区分好坏。如果方案被拒绝,先让 Agent 根据原因修正;此时还没有开始正式搜索。
优化过程
Agent 告知搜索已经启动后,打开会话中的演进任务面板。搜索在后台运行,关闭面板不会停止它。
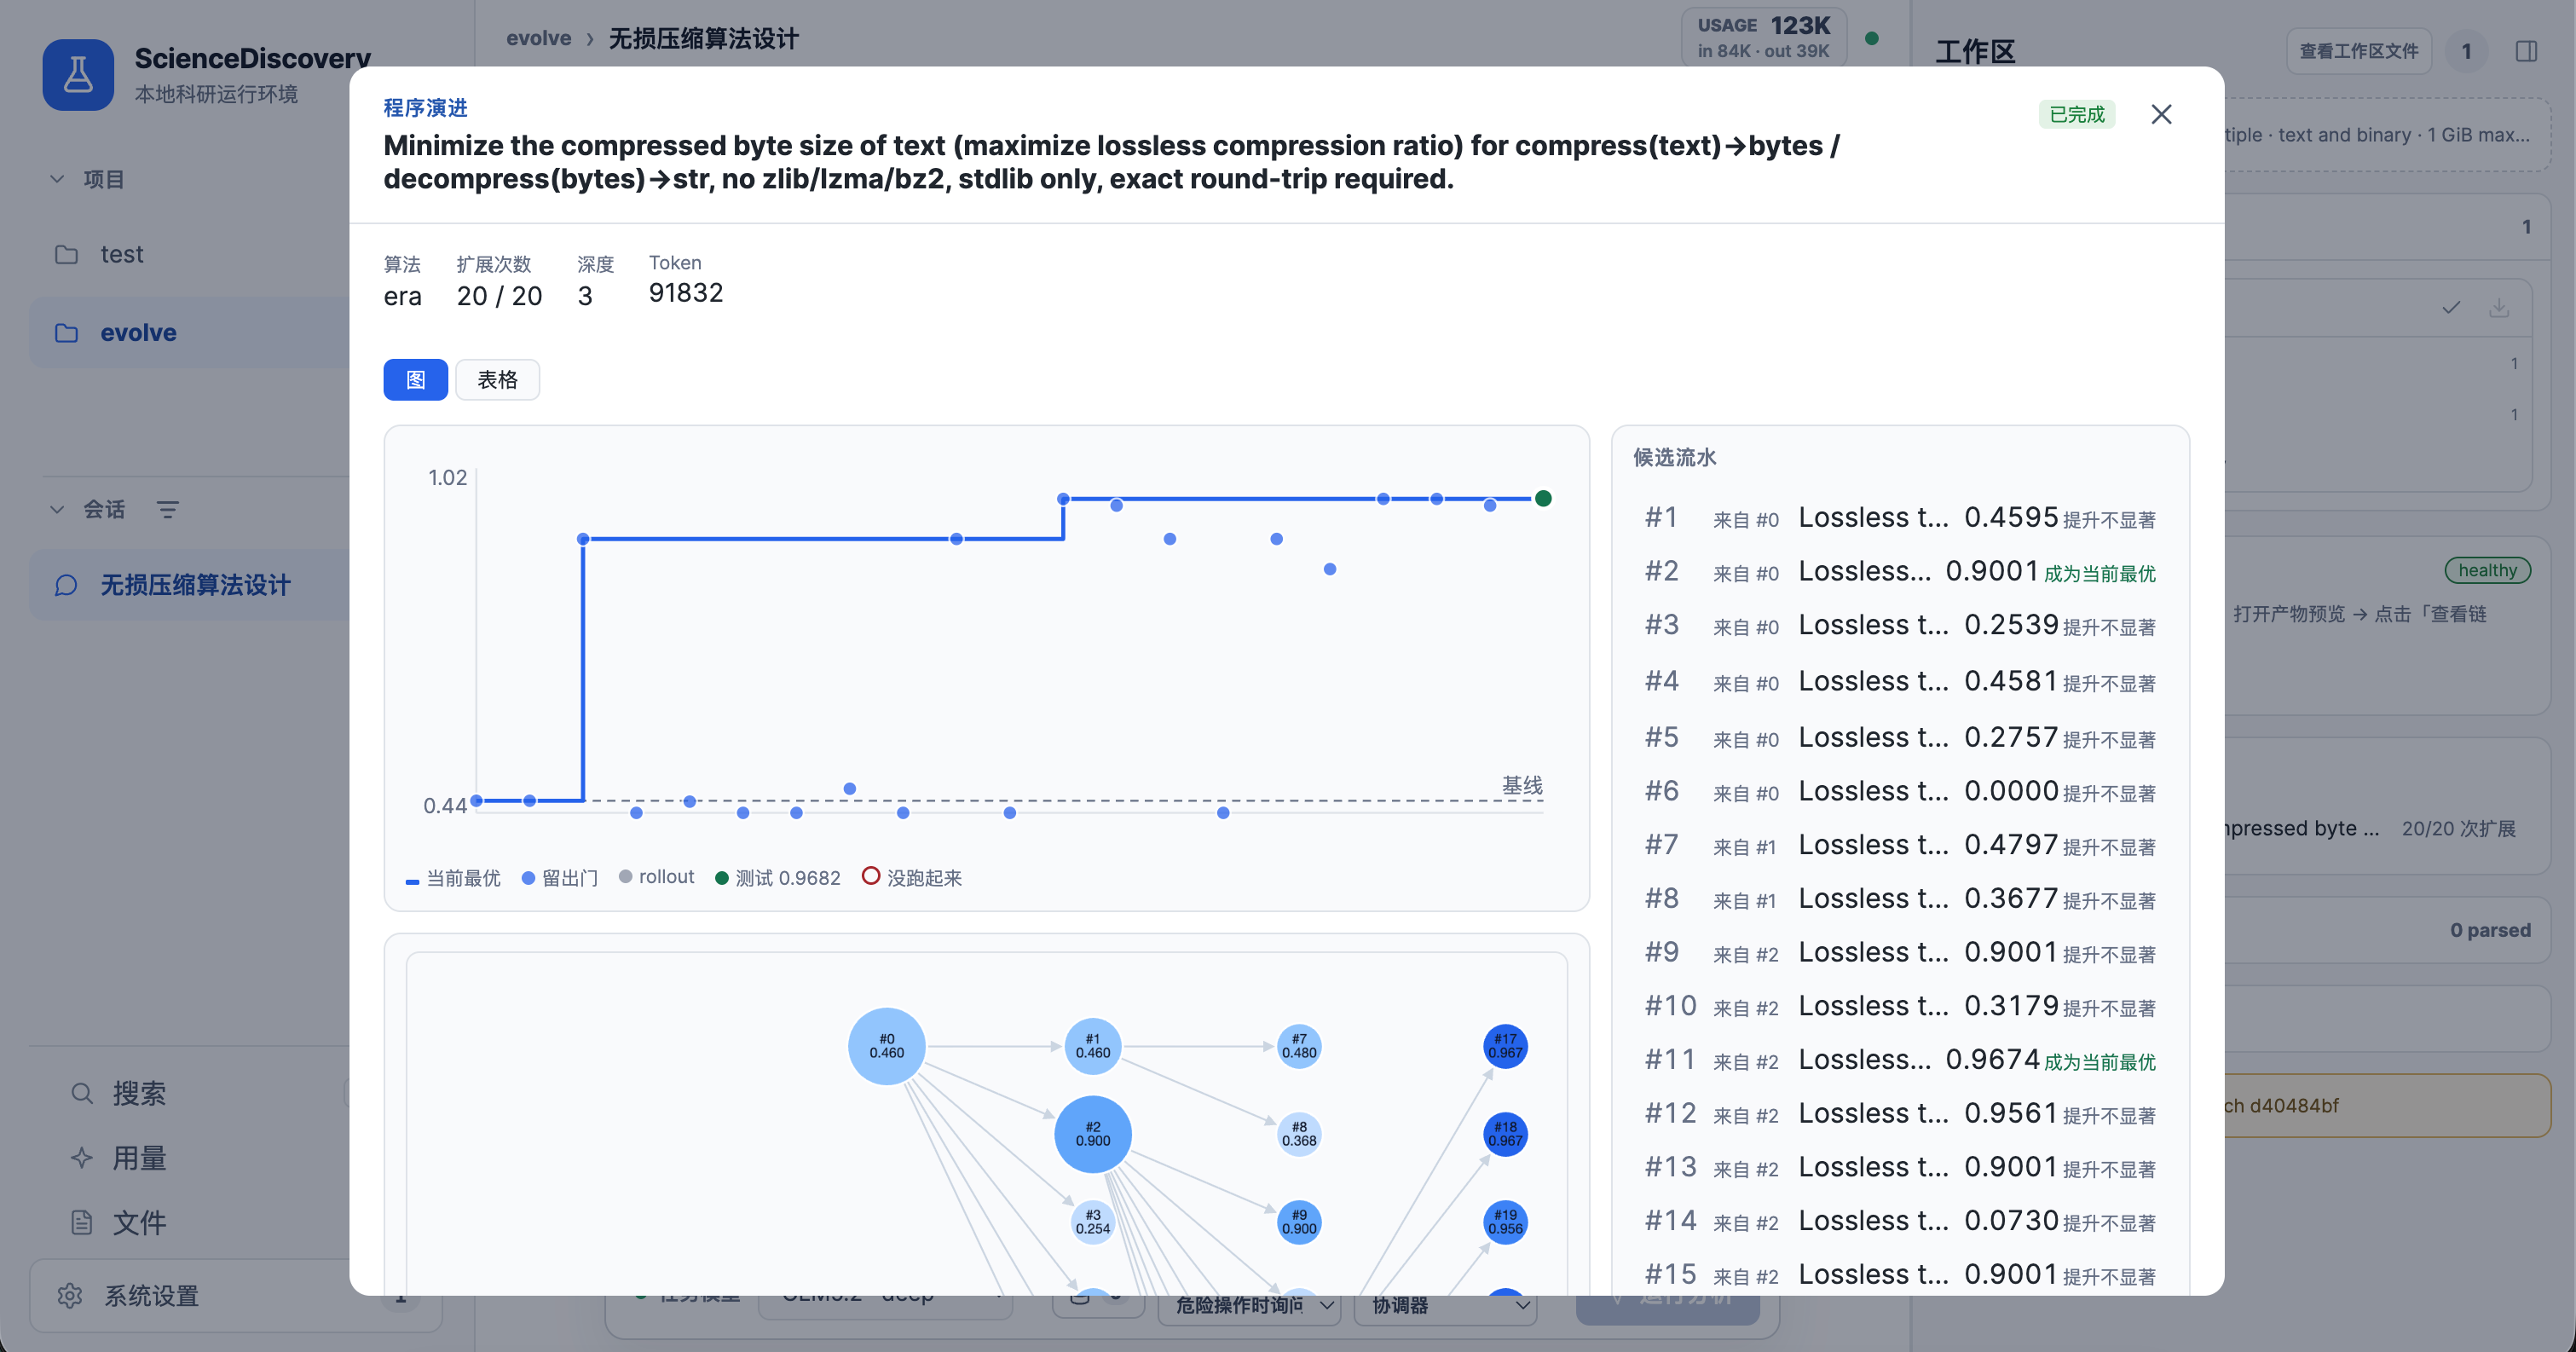
先看起点基线,再观察最优分数是否随着新候选出现而提高。你不需要读懂每个算法细节,可以从候选流水中查看:这次改了什么、是否运行成功、得分多少、有没有成为新的最优版本。
某些候选会有语法错误、解压失败或得分下降。这些尝试本身不意味着整个任务失败;重要的是失败是否被记录,以及搜索是否继续并最终结束。
本次真实运行的起点是逐字节 Huffman 编码。搜索尝试了区间编码、利用前面的字节预测当前字节,以及重复片段匹配等方向。最终保留的实现使用前 1~3 个字节的上下文统计,再通过区间编码压缩文本。
等待面板显示搜索结束。主 Agent 回复“搜索已启动”时,后台工作可能才刚开始,不能把这条回复当成优化已经完成。
结果分析
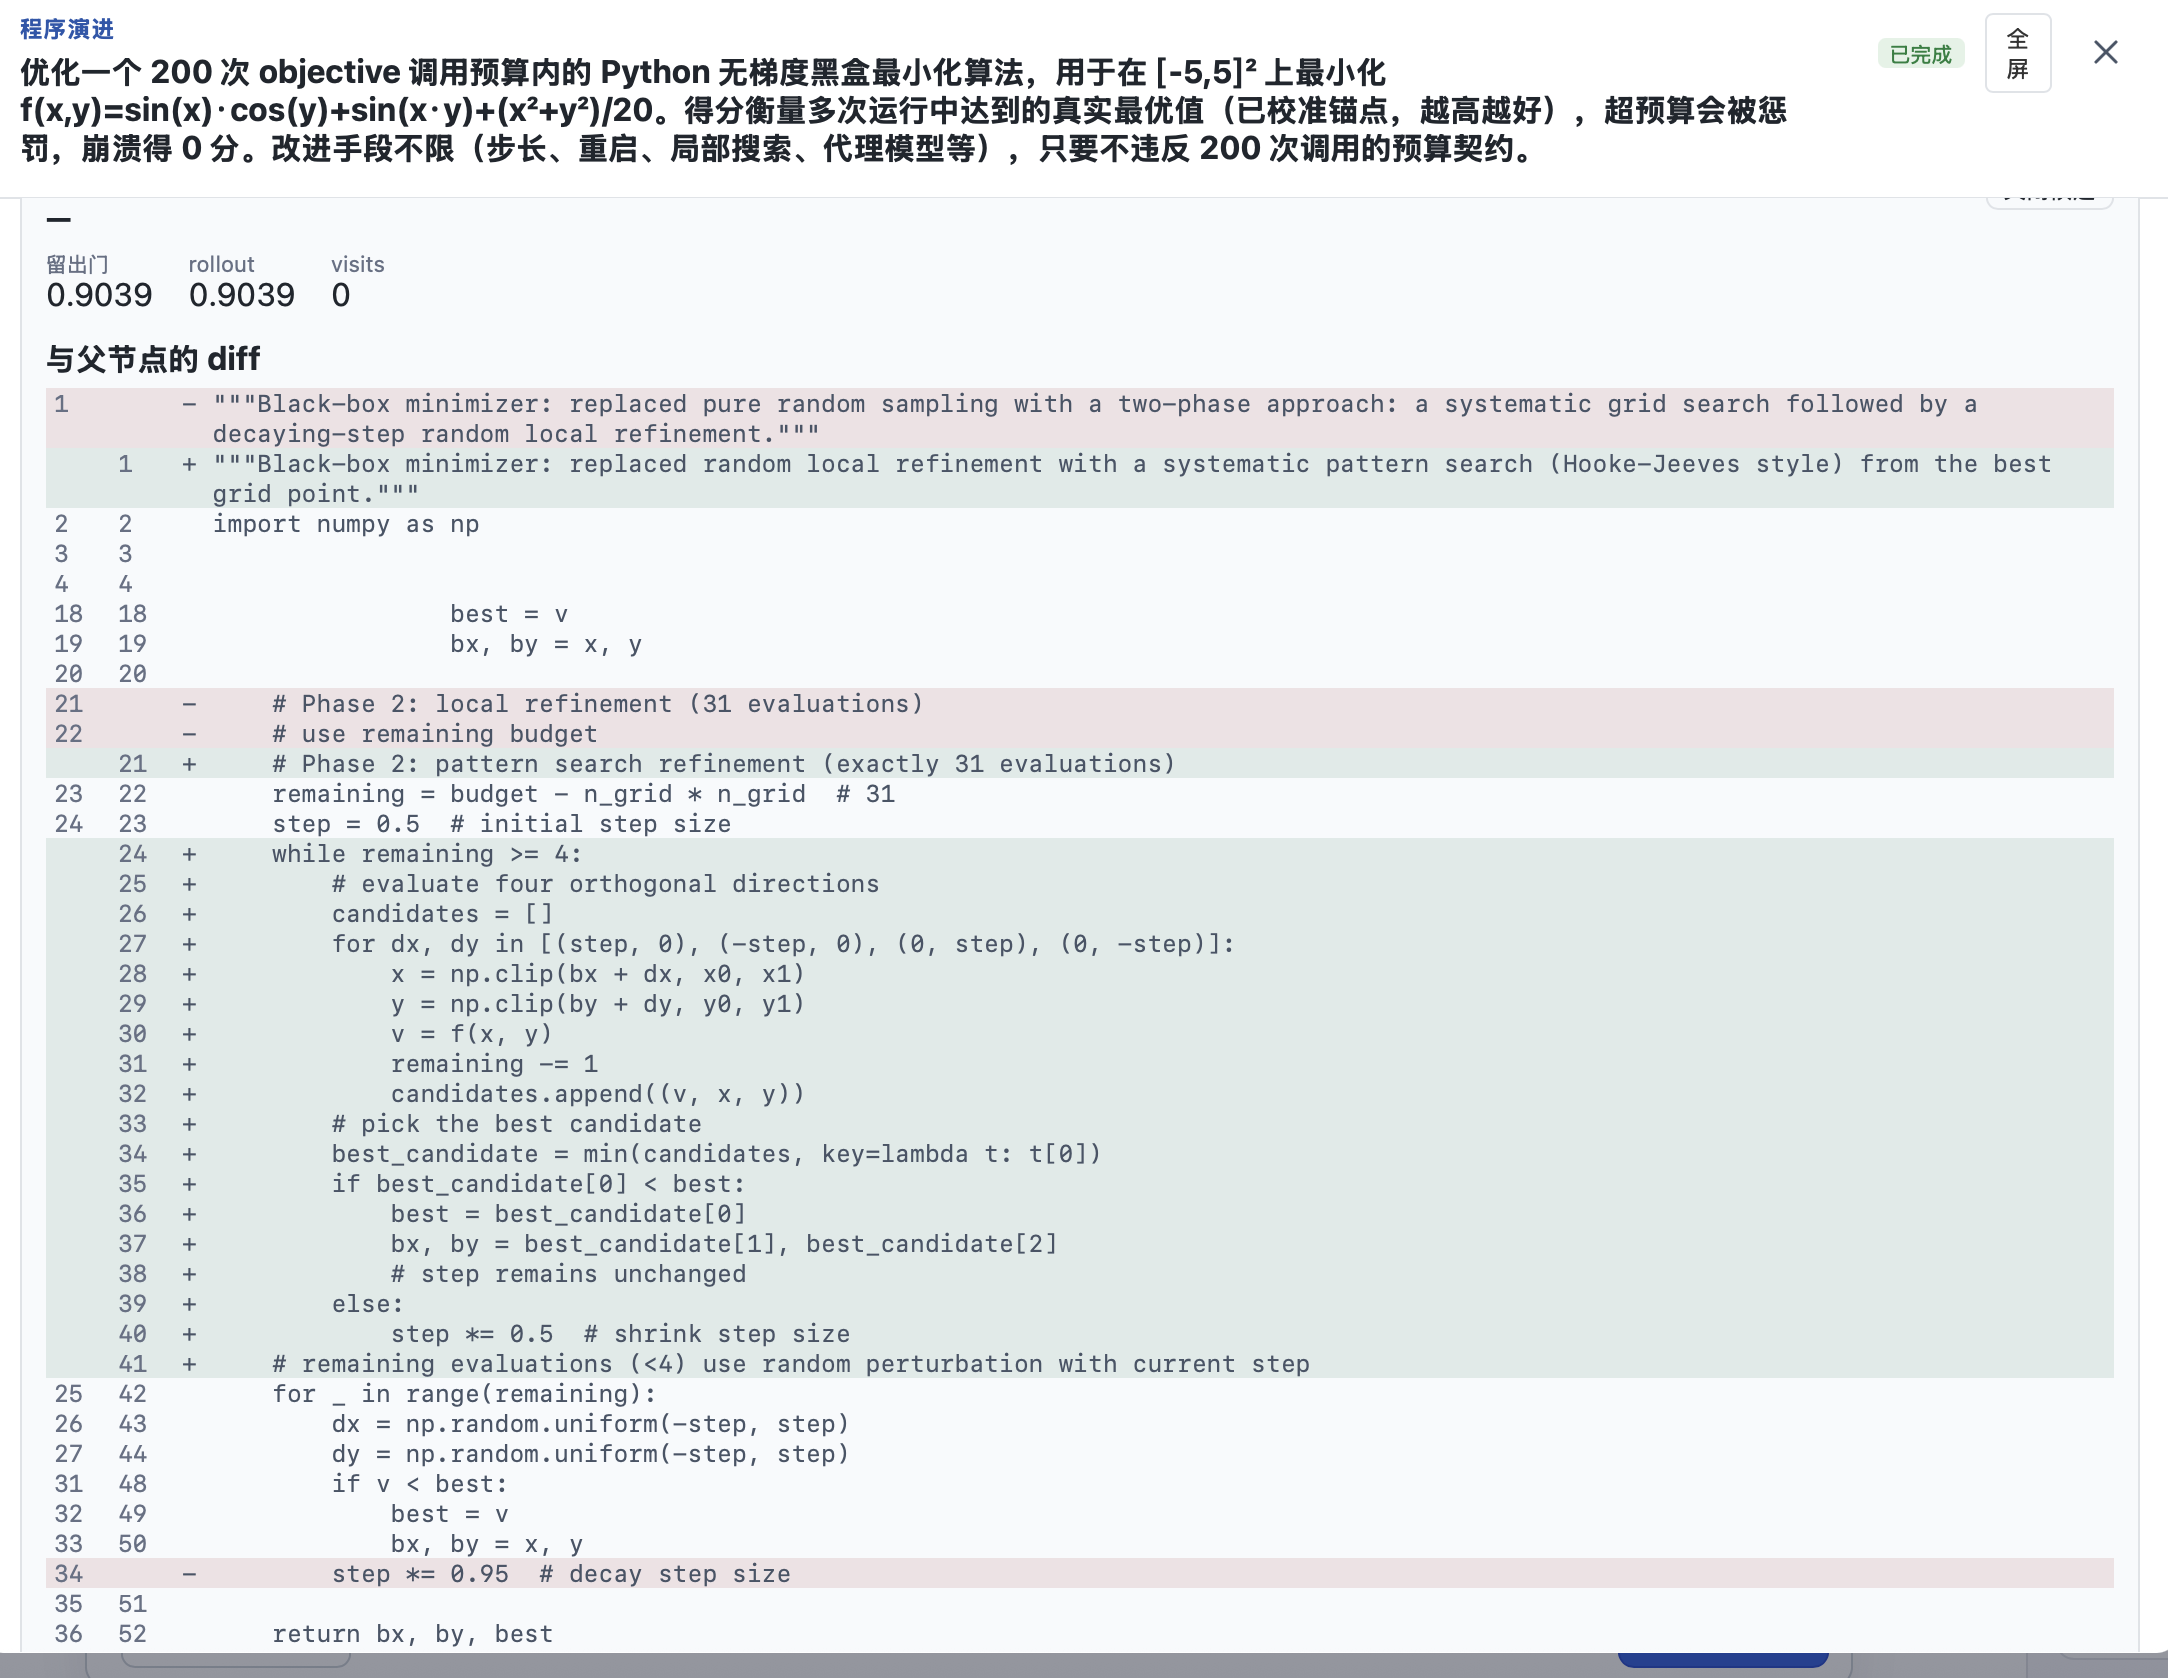
先打开结果产物,比较起点与最优代码。一次有改进的搜索会将它们保存为同一结果产物的两个版本,便于查看差异和下载。
下面是 2026-09-25 一次真实 E2E 的记录,使用 DeepSeek Flash,执行 16 次扩展、4 个 worker;从提交任务到搜索结束约 6 分 47 秒:
| 指标 | 本次结果 | 如何理解 |
|---|---|---|
| 起点 gate 分 | 0.5757 | 初始算法在搜索评分集上的表现 |
| 最优候选 gate 分 | 0.9540 | 在相同评分集上取得了改进 |
| 最优候选 test 分 | 0.9224 | 最终算法在未参与搜索的数据上的表现 |
先比较前两项,判断搜索是否改进了起点;再看留出 test 分,判断改进是否也出现在未参与搜索的数据上。本次 test 分略低于 gate 分,但仍取得了较高的评测分。不同分片的难度可能不同,这不能代替真实业务数据验证。
0.9224 不等于文本缩小了 92.24%。 本次 Agent 编写的评测器,对每条文本计算:
得分 = clamp((1 − 压缩后字节数 / 原始 UTF-8 字节数) / 0.75, 0, 1)
最终分数 = 各条文本得分的平均值
在这个定义下,缩小 75% 就达到单条文本的满分,更大的压缩收益也只计 1 分。由于逐条截断再取平均,不能把最终分数直接换算为整批文件的压缩率。实际节省多少空间,应查看压缩前后的原始字节数。
这套公式是本次任务生成的评测器定义,不是 PUCT 固定采用的公式。你再次运行时,先阅读 Agent 对评分方式的说明,再解释它给出的数字。
注意事项
- 完成与质量分开看。 搜索正常结束、结果代码可以读取,说明流程完成;是否优于起点、提升多少,要看评测分。没有改进也可以是一次有效的搜索结果。
- 本次数据是合成文本。 高分不代表对任意真实文件同样有效。准备投入使用前,应补充自己的文件,验证无损往返、压缩率、耗时和内存。
- 检查评分上限。 如果多个候选都达到满分,评测器将无法继续区分它们。本次“缩小 75% 即满分”也有这个限制。
- 留出数据也有范围限制。 test 分高只能说明它在这组未参与搜索的数据上表现较好,不是通用压缩能力的证明。
- 失败时先区分阶段。 方案被探针拒绝、单个候选失败、整个搜索失败,是三种不同情况。查看面板中的具体原因,不要仅凭某个候选得零分就重新启动全部任务。
- 分数不会每次相同。 Agent 生成的起点、文本和评测器可能不同。跨运行比较时,应先确认评测定义一致,不能直接用不同评分器的数字比较算法优劣。